
엔비디아 베라 루빈 블랙웰, 와트당 에이전틱 AI 성능의 새로운 기준 제시
엔비디아가 에이전틱 AI 추론 성능을 평가하는 세미애널리시스의 ‘에이전트X(AgentX)’ 벤치마크 결과를 공개하며 차세대 AI 인프라의 전력 효율성을 강조했다.
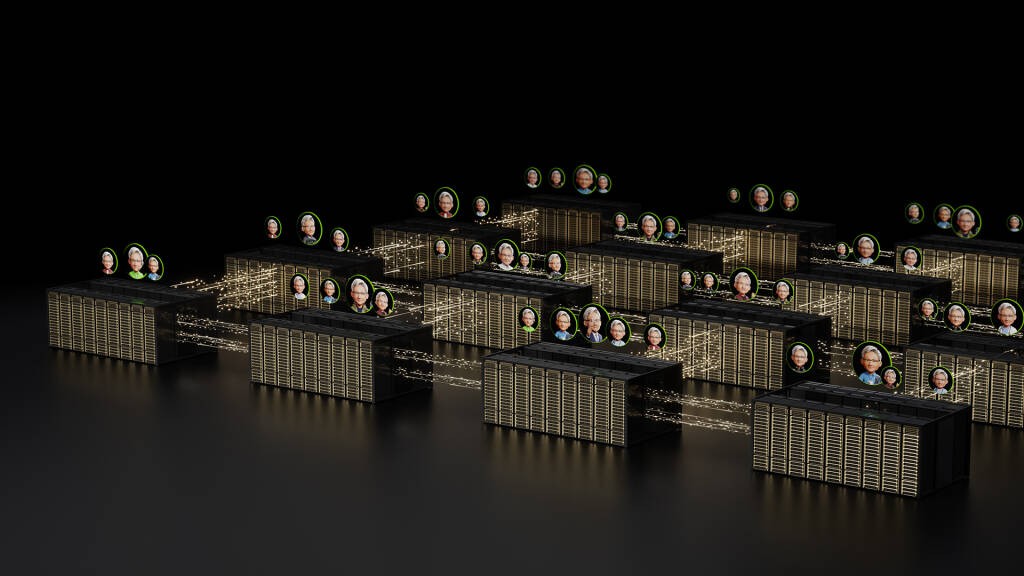
에이전트X는 실제 코딩 에이전트의 작업 환경을 재현해 긴 컨텍스트 처리, KV 캐시 재사용, 반복적인 모델 호출, 도구 사용 등 실제 에이전틱 AI 워크로드에서의 성능을 측정하는 벤치마크다. 기존의 고정된 프롬프트·응답 방식보다 실제 AI 에이전트의 사용 패턴을 보다 현실적으로 반영하는 것이 특징이다.
엔비디아에 따르면 에이전틱 AI는 일반적인 대화형 AI보다 훨씬 많은 토큰을 소비한다. 오픈라우터의 실제 사용 데이터 분석에서도 요청당 평균 프롬프트 토큰 수가 크게 증가했으며, 단일 에이전트 요청은 일반 채팅보다 약 15배 많은 토큰을 사용하는 것으로 나타났다.
특히 전력 효율을 나타내는 ‘메가와트당 처리량’이 핵심 지표로 제시됐다. 에이전트X는 메가와트당 토큰 처리량과 함께 사용자당 출력 속도, 엔드투엔드 지연시간, 첫 토큰 생성 시간(TTFT) 등을 종합적으로 평가한다.
엔비디아가 공개한 프리뷰 결과에서는 차세대 베라 루빈 NVL72가 딥시크 V4-Pro 워크로드에서 동일한 응답성을 기준으로 블랙웰 GB300 NVL72보다 메가와트당 AI 팩토리 처리량을 최대 30배 높인 것으로 나타났다. 다만 해당 결과는 현재 세미애널리시스의 검토가 진행 중인 프리뷰 결과다.
블랙웰 GB300 NVL72 역시 이전 세대 대비 큰 폭의 전력 효율 향상을 보였다. 에이전트X에서 딥시크 V4 Pro 1.6T를 실행한 결과 H200 NVL8보다 메가와트당 처리량이 최대 15배 높았으며, 100만 토큰당 비용은 최대 10분의 1 수준으로 낮아졌다.
대규모 모델에서는 격차가 더욱 커졌다. 키미 K3 2.8T 테스트에서 GB300 NVL72는 비슷한 인터랙티브 성능 조건에서 H200 NVL8보다 메가와트당 약 80배 높은 처리량을 기록했다.
이 같은 성능은 단순히 GPU 자체의 연산 성능뿐 아니라 SGLang, TensorRT-LLM, vLLM 등의 MoE 서빙 기술과 DeepGEMM, 혼합 정밀도 연산, 전문가 병렬화 등이 결합된 결과라는 설명이다. 또한 엔비디아 다이나모(Dynamo)는 프리필과 디코드 작업을 분리하고 KV 캐시를 효율적으로 재사용해 멀티턴 에이전트 워크로드의 응답성을 높인다.
엔비디아는 베라 루빈 플랫폼이 GPU뿐 아니라 베라 CPU, Groq 3 LPX, NVLink 6, ConnectX-9, BlueField-4, Spectrum-X 등을 하나의 AI 인프라로 연결해 에이전틱 AI 처리량과 전력 효율을 높이는 방향으로 설계됐다고 강조했다.
결국 엔비디아가 이번 벤치마크를 통해 강조한 것은 단순한 GPU 성능 경쟁을 넘어, 긴 컨텍스트와 반복적인 추론·도구 호출이 필요한 에이전틱 AI 시대에는 ‘전력당 처리량’과 실제 사용자 응답성이 핵심 경쟁력이 된다는 점이다.
케이벤치 많이 본 뉴스
애플 '아이폰 듀오' 올해 500만대 출하…시장 점유율 24.8% 전망
당초 1999달러였는데…메모리 부족에 '아이폰 울트라' 2199달러부터 시작하나
2028년형 제네시스 G90 전면 디자인 유출…GV90 닮은 크레스트 그릴
케이벤치 많이 본 기사
[기획] 클라우드 넘어 '로컬 AI'로, 나만의 AI 에이전트 PC 맞춤 구성 가이드
[기획] 성능은 그대로, 그래픽 품질 개선.. 엔비디아 DLSS 4.5 레이 리컨스트럭션
[기획] 미야모토 무사시가 보여줄 검의 길과 함께할 CPU는? 귀무자: 검의 길 CPU 6종 벤치마크